유니티 메모리 구조와 CoreCLR 이해하기
유나이트 서울 2026의 「유니티 메모리 구조와 CoreCLR 이해하기」 강연을 바탕으로, 주요 내용을 보강하고 GC의 동작 과정을 더 자세히 기술하였다. 이 글에서는 Unity 엔진의 메모리와, 최적화 팁 그리고 GC의 정책을 이해한다.
운영체제가 보는 메모리부터 구분한다
애플리케이션은 물리 메모리의 주소를 직접 사용하지 않는다. 운영체제가 제공하는 가상 주소를 사용하고, MMU가 이를 물리 메모리의 페이지와 연결한다. 페이지는 운영체제가 메모리를 관리하는 기본 크기의 블록이다.
Memory Profiler의 수치를 이해할려면 세 상태를 구분해야 한다.
- Reserved는 다른 용도로 사용하지 못하도록 가상 주소 범위를 확보한 상태이다.
- Committed는 해당 주소에 실제 저장 공간을 제공하기로 운영체제가 약속한 상태이다.
- Resident는 현재 물리 메모리에 올라와 CPU가 바로 접근할 수 있는 상태이다.
Reserved가 크다고 그만큼의 물리 메모리를 전부 점유했다는 뜻은 아니다. Unity Memory Profiler에서도 Reserved와 Used는 같은 의미의 숫자가 아니다. 프로파일링에서는 수치의 크기보다 먼저 그 수치가 어느 상태를 나타내는지 확인해야 한다.
페이지도 복원 가능 여부에 따라 다르게 취급된다.
- clean page는 원본 파일이나 에셋에서 다시 읽어 복원할 수 있는 페이지이다.
- dirty page는 실행 중 계산과 쓰기로 바뀌어 같은 내용을 다시 읽어 올 수 없는 페이지이다.
운영체제는 메모리가 부족할 때 clean page를 비교적 쉽게 비울 수 있다. dirty page는 압축하거나 별도 공간에 보관해야 하므로 부담이 더 크다. 모바일에서는 앱이 정해진 메모리 한도를 넘으면 프로세스 자체가 종료될 수도 있다.
이제 Unity의 Managed Heap이 객체를 할당하고 회수하는 구조를 살펴본다.
Managed 메모리는 참조를 따라 관리한다
먼저 GC 설명에 필요한 용어를 정리한다.
- Managed Heap은 GC가 객체의 할당과 수거를 관리하는 메모리 영역이다.
- GC root는 살아 있는 객체를 탐색할 때 출발점이 되는 참조이다.
- Mark는 root에서 도달할 수 있는 객체에 생존 표시를 남기는 단계이다.
- Sweep은 표시되지 않은 객체의 자리를 다시 사용할 수 있게 회수하는 단계이다.
- free list는 회수한 빈 슬롯을 객체 크기 등급별로 연결해 둔 목록이다. 새 객체를 할당할 때 힙을 처음부터 탐색하지 않고, 크기가 맞는 목록에서 빈 슬롯을 빼내 재사용한다.
- 보수적 참조 판정은 GC가 스택과 레지스터의 값을 정확한 참조인지 구분하지 못할 때, Managed Heap의 주소처럼 보이는 모든 값을 참조 후보로 취급하는 방식이다. 살아 있는 객체를 잘못 회수하지 않는 대신, 죽은 객체가 참조된 것처럼 오판되어 남을 수 있다.
클래스 인스턴스, 배열, 컬렉션과 문자열 같은 참조 형식 객체는 Managed Heap에 놓인다.
개발자가 C/C++의 free() 함수처럼 해제 함수를 직접 호출하지 않아도 GC가 도달할 수 없는 객체의 자리를 회수한다.
GC가 회수하는 대상은 “더 이상 사용하지 않는 객체”가 아니라 “root에서 도달할 수 없는 객체”이다. 코드가 객체를 논리적으로 사용하지 않아도 root에서 참조가 이어지면 객체는 살아 있다.
대표적인 GC root에는 static 필드, 스레드 스택의 지역 변수, CPU 레지스터와 GC handle이 있다. 싱글턴의 필드, 해제하지 않은 이벤트 구독과 클로저가 캡처한 객체도 계속 다른 객체를 참조할 수 있다. 그 참조가 남아 있으면 GC는 객체를 안전하게 수거할 수 없다.
Boehm GC는 빈자리를 찾아 할당한다
Unity의 기존 Mono와 IL2CPP 백엔드는 Boehm-Demers-Weiser GC를 사용한다.
Incremental GC는 한 번에 실행할 GC 작업을 여러 프레임으로 나누는 방식이다.
Unity 공식 문서에 따르면 이 모드는 기본적으로 활성화되어 있다.
다만 실제 사용 여부는 Player Settings에서 제어한다.
Player Settings > Other Settings > Configuration의 Use Incremental GC에서 확인할 수 있다.
작은 객체를 할당할 때는 대략 다음 흐름을 따른다.
- 요청한 객체 크기에 맞는 free list를 찾는다.
- 목록에 빈자리가 있으면 요청한 크기 등급의 빈 슬롯에 객체를 할당한다.
- 적절한 빈자리가 없으면 아직 Sweep하지 않은 블록에서 빈자리를 찾는다.
- 그래도 공간이 없으면 GC를 실행하거나 Managed Heap을 확장한다.
큰 블록을 8바이트, 16바이트 같은 크기 등급의 슬롯으로 나누면 할당 요청에 맞는 빈자리를 빠르게 찾을 수 있다.
객체의 바이트는 하나의 연속된 주소 범위에 저장되어야 한다. 따라서 큰 객체를 할당하려면 작은 빈 슬롯 여러 개의 총합이 아니라, 객체 전체가 들어갈 하나의 연속 공간이 필요하다. 이 공간을 찾지 못하면 GC가 시작되며, Boehm GC는 Mark-Sweep으로 도달할 수 없는 객체의 자리를 다시 할당할 수 있게 만든다.
Boehm GC의 Mark-Sweep은 어떻게 동작하는가
Boehm GC의 기본 수거 과정은 Mark-Sweep이다. 객체 그래프를 따라 순서대로 보면 다음과 같다.
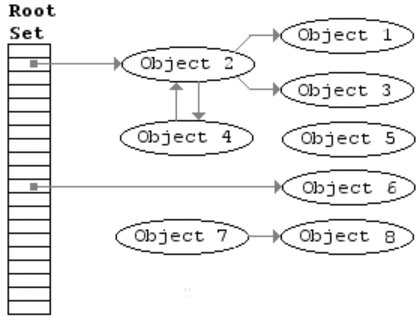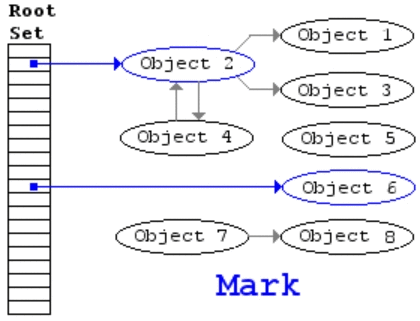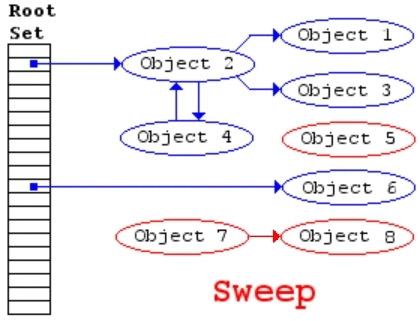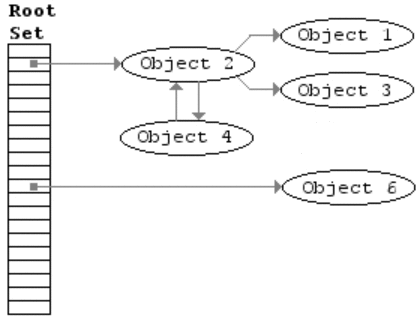
출처: Wikimedia Commons, Animation of the Naive Mark and Sweep Garbage Collector Algorithm (CC0 1.0)

1. 모든 객체를 수거 후보로 놓는다
각 객체에는 생존 여부를 표시하는 mark bit가 있다. 수집을 시작할 때는 기존 표시를 지우고 모든 객체를 아직 확인하지 않은 상태로 둔다.
2. root 후보를 조사한다
Boehm GC는 스택, 레지스터와 static 데이터 영역을 조사한다. GC는 이 영역에서 현재 실행 중인 코드가 직접 가리키는 객체를 root 후보로 모은다. 이 root 후보가 Mark 단계의 출발점이 되며, root에서 참조를 따라 도달한 객체만 생존 객체로 판단한다.
3. 도달 가능한 객체를 Mark한다
root 후보가 가리키는 객체에 생존 표시를 남긴다. 그 객체가 다른 객체를 참조하면 화살표를 따라가며 같은 작업을 반복한다.
위 그림에서 root set은 객체 2와 6을 직접 가리킨다. 객체 2의 참조를 따라가면 객체 1, 3, 4에도 도달하므로 이 다섯 객체는 Mark된다. root에서 도달할 경로가 없는 객체 5, 7, 8은 미표시 상태로 남아 Sweep 대상이 된다.
4. 표시되지 않은 자리를 Sweep한다
Mark가 끝나면 표시되지 않은 객체는 수거 대상이다. Sweep은 그 객체가 사용하던 슬롯을 free list에 돌려보낸다.
여기서 “수거”는 객체의 모든 바이트를 즉시 운영체제에 반납한다는 뜻이 아니다. 객체가 사용하던 자리를 Managed Heap 내부의 빈 공간으로 바꿀 뿐, 운영체제에는 반납하지 않는다.
이 네 단계를 짧게 답하면 다음과 같다.
Boehm GC는 root 후보에서 시작해 도달 가능한 객체를 Mark한다. 표시되지 않은 객체를 Sweep하고, 그 자리를 free list로 돌려보낸다.
Sweep이 끝나도 메모리가 깔끔하게 모이지는 않는다
Sweep은 죽은 객체의 자리만 빈 공간으로 바꾼다. 객체 A와 C가 살아 있고 그 사이의 B만 죽었다면 B의 자리만 구멍으로 남는다.
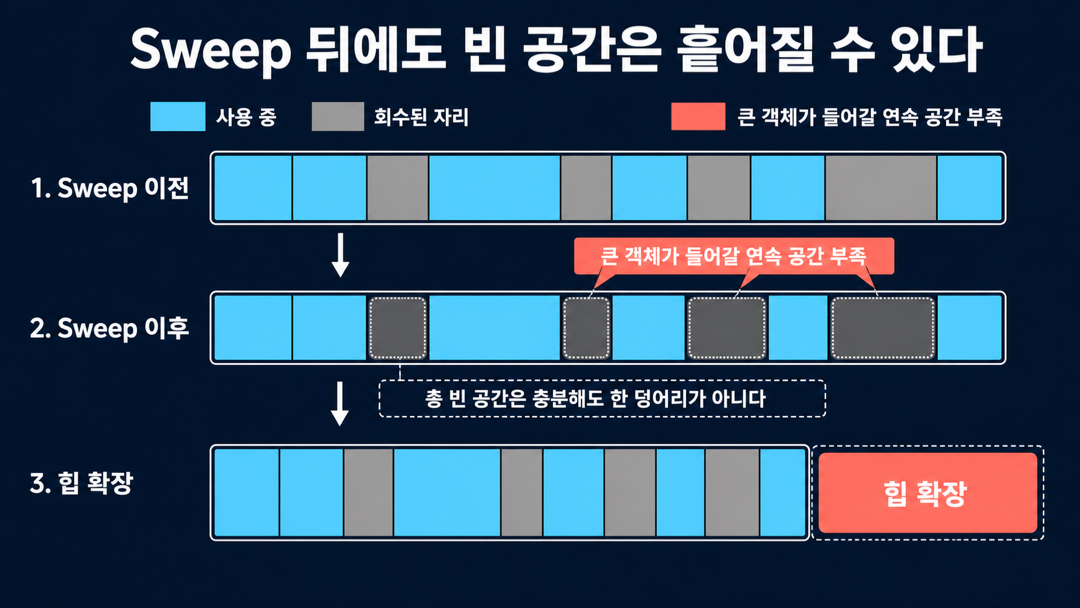
예를 들어 1MB짜리 빈 공간 네 개가 살아 있는 객체 사이사이에 나뉘어 있다고 해보자. 전체 빈 공간은 4MB이지만, 4MB 객체를 저장할 연속 공간은 없다. 이처럼 충분한 빈 공간이 여러 군데로 흩어져 할당에 사용하지 못하는 현상을 외부 단편화라고 한다. 외부 단편화는 Boehm GC가 객체를 이동하지 않는 구조에서 발생하는 대표적인 문제이다. 여기에 보수적 참조 판정의 오탐이 겹치면 불필요한 객체가 더 오래 남고 힙이 새로 확장될 가능성도 커진다.
- 보수적 판정의 오탐: GC가 스택과 CPU 레지스터를 조사할 때 보는 것은 일정한 크기의 비트 값이다. 각 값에 “이것은 객체 참조” 또는 “이것은 정수”라는 자료형 표시가 항상 붙어 있지는 않다. Boehm GC는 그 값이 Managed Heap 내부의 주소와 같거나 그 범위에 들어오면 일단 참조로 간주한다. 따라서 일반 정숫값이 우연히 객체 주소와 일치하면, 참조가 없는 객체도 생존 객체로 판정한다.
- 비압축 방식의 파편화: Boehm GC는 생존 객체를 다른 주소로 재배치하지 않는다. Sweep으로 회수한 자리는 생존 객체 사이에 흩어진 채 남으므로, 이 공간들을 큰 연속 공간 하나로 합칠 수 없다.
- 총 여유 공간이 충분해도 알맞은 빈 블록이 없어 힙이 확장될 수 있다.
- 힙이 커지면 다음 Mark에서 조사해야 할 범위와 캐시 비용도 커질 수 있다.
빈 페이지가 통째로 비면 일부 메모리를 운영체제에 돌려줄 수 있다.
그러나 언제 반환되는지는 보장되지 않는다.
GC.Collect를 여러 번 호출하는 방법은 CPU 비용도 매우 크다.
특정 횟수만큼 GC를 호출하면 반드시 운영체제 메모리가 줄어든다고 가정하면 안 된다. 전체 페이지가 비어 있어야 하며 반환 정책은 플랫폼과 런타임 구현에 따라 달라진다.
Incremental GC는 긴 Mark를 여러 프레임으로 나눈다
Incremental GC는 한 번의 GC 작업을 여러 조각으로 나누어 실행하는 방식이다. Unity에서는 특히 Mark 작업을 여러 프레임에 분산한다.
이 과정을 이해하려면 tri-color marking이라는 설명 모델이 유용하다.
- 흰색은 아직 조사하지 않은 객체이다.
- 회색은 살아 있음을 확인했지만 자식 참조를 모두 조사하지 않은 객체이다.
- 검은색은 자신과 자식 참조를 모두 조사한 객체이다.
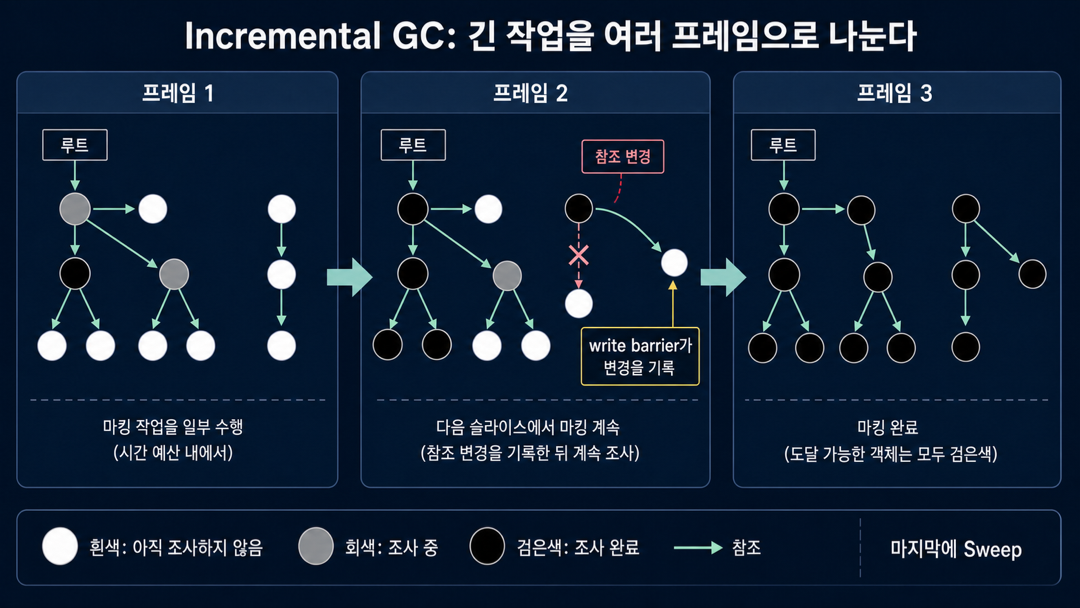
첫 번째 프레임에서는 root 주변의 일부 객체만 조사한다. 두 번째 프레임에서는 남아 있는 회색 객체의 참조를 따라간다. 모든 도달 가능한 객체가 검은색이 되면 마지막에 Sweep을 진행한다.
문제는 Mark 도중 애플리케이션 코드가 참조를 바꿀 수 있다는 점이다. 이미 조사를 마친 객체가 아직 조사하지 않은 객체를 새로 가리키면 GC가 그 객체를 놓칠 수 있다.
이때 쓰기 장벽(write barrier)이 동작한다. 쓰기 장벽은 코드가 Managed 참조 필드를 바꿀 때 런타임이 그 변경을 감지하고 기록하는 장치이다. 변경된 객체를 다시 조사하도록 기록해 살아 있는 객체가 잘못 수거되는 일을 막는다.
Incremental GC는 전체 작업량을 없애지 않는다. 한 프레임의 긴 정지를 여러 프레임의 짧은 정지로 나누어 프레임 스파이크를 줄인다. 참조 변경이 많으면 write barrier 비용과 재조사 작업도 늘어난다.
변경량이 너무 많으면 Incremental Mark가 끝나지 못할 수 있다. 이 경우 GC는 전체 수집으로 되돌아갈 수 있다.
Managed 메모리 최적화의 출발점은 참조 수명이다
Managed 메모리 문제는 대부분 불필요한 참조가 객체의 수명을 늘리거나, 짧은 수명의 객체를 반복해 할당할 때 시작한다. 다음 사례는 이 두 원인을 실제 Unity 코드에서 어떻게 찾을지 보여 준다.
Disable은 참조를 끊지 않는다
오브젝트 풀에서 객체를 SetActive(false)로 비활성화해도 참조는 그대로 남는다.
Pool, List나 Dictionary가 객체를 계속 가리키면 GC는 그 객체를 살아 있다고 판단한다.
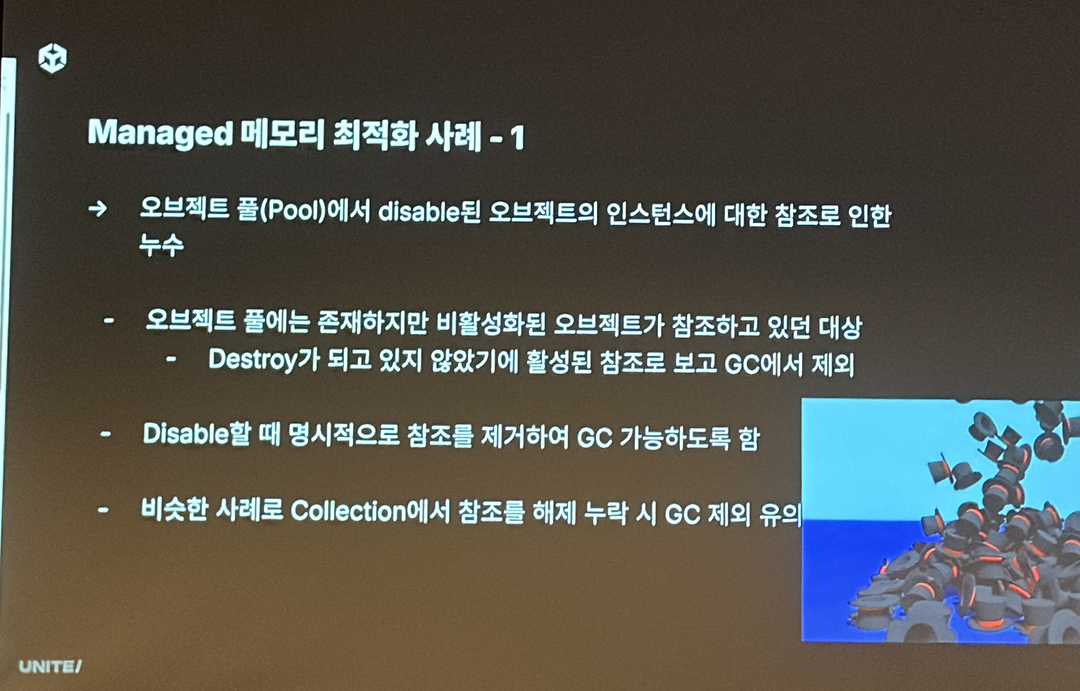
비활성화는 Unity 생명주기의 동작을 멈출 뿐이며, Managed 참조를 제거하지 않는다. 풀에서 정말 제거할 객체라면 컬렉션의 참조도 함께 정리해야 한다.
씬이 바뀌어도 C# 참조는 남을 수 있다
LoadSceneMode.Single은 기존 씬을 닫고 새 씬을 연다.
최신 Unity API 문서는 이때 Resources.UnloadUnusedAssets도 자동 호출한다고 설명한다.
하지만 순수 C# 객체와 static 필드는 씬 계층과 별개이다.
DontDestroyOnLoad 객체, 싱글턴, 이벤트와 delegate가 참조하면 Managed 객체가 남는다.
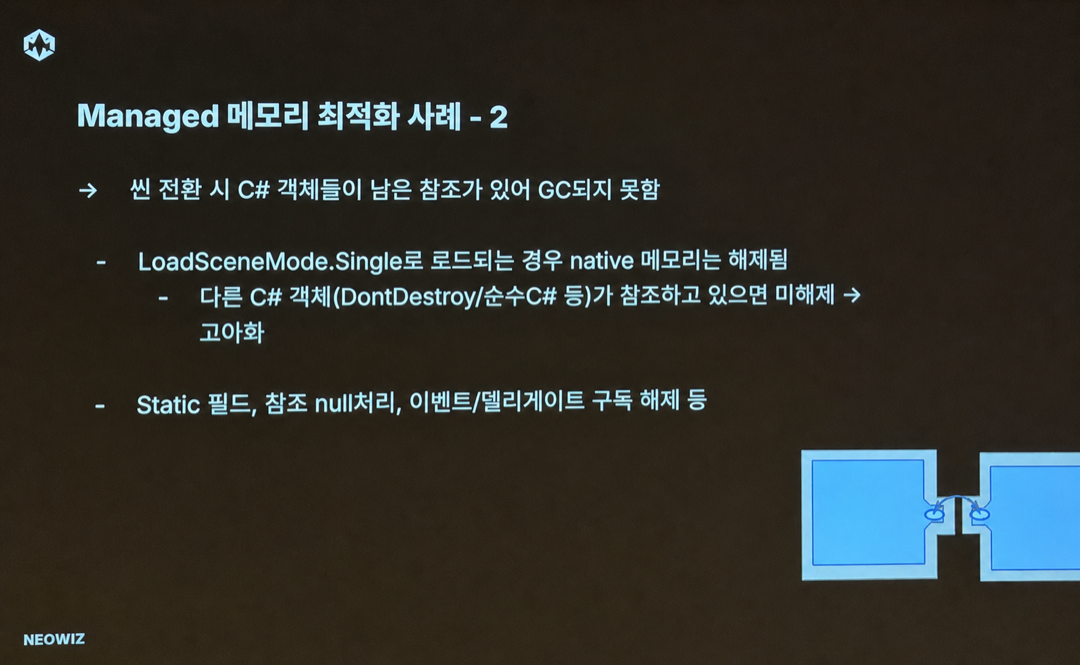
클로저(closure)는 lambda나 로컬 함수가 바깥 스코프의 변수를 캡처해 함수 호출 후에도 그 값을 보관하는 구조이다. 따라서 씬 전환 뒤 객체가 남는다면 먼저 다음 항목을 확인한다.
- static 필드를
null로 정리했는가 - List와 Dictionary에서 항목을 제거했는가
- 이벤트와 delegate 구독을 해제했는가
- 클로저가 씬 객체를 캡처하고 있지 않은가
NonAlloc API는 결과 버퍼를 재사용한다
NonAlloc API는 새 결과 배열을 반환하지 않고, 호출자가 미리 만든 버퍼에 결과를 기록해 반복 할당을 줄이는 Unity API 패턴이다.
Physics.RaycastAll처럼 결과 배열을 반환하는 API는 호출마다 배열을 만들 수 있다.
매 프레임 많은 객체가 호출하면 작은 할당도 빠르게 누적된다.
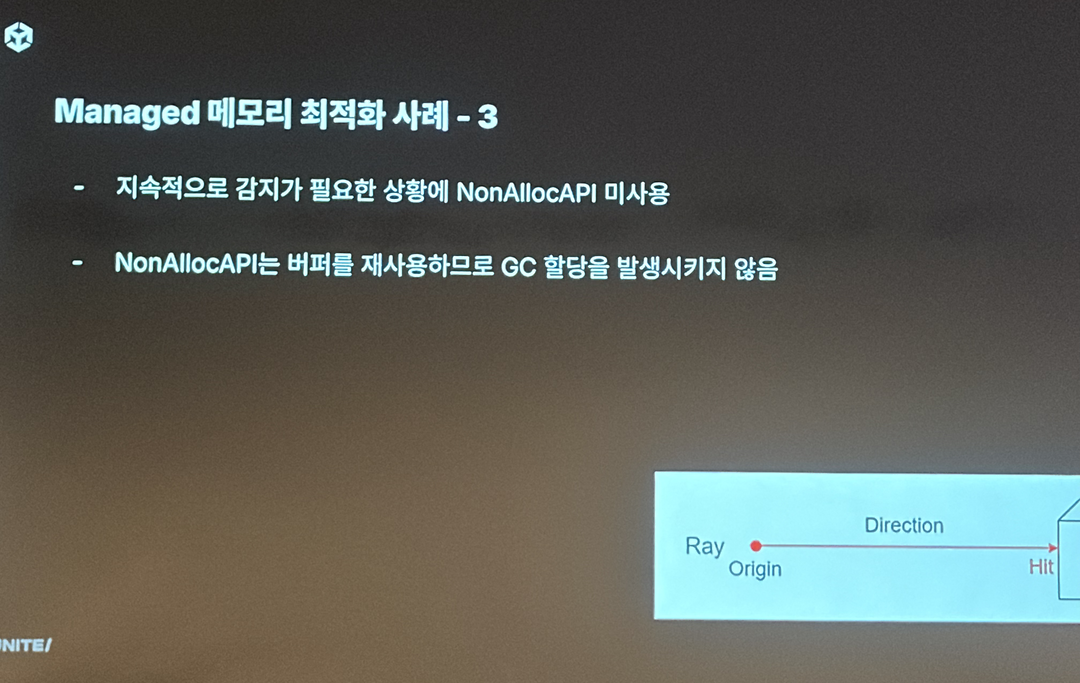
Physics.RaycastNonAlloc은 호출자가 만든 RaycastHit[]에 결과를 기록한다.
같은 배열을 반복 사용하므로 결과 배열을 매번 새로 할당하지 않는다.
대형 직렬화는 순간 할당량을 본다
대형 JSON은 최종 파일 크기만큼만 메모리를 사용하지 않는다. 문자열, 파서의 중간 객체와 최종 데이터 구조가 한동안 함께 존재할 수 있다.
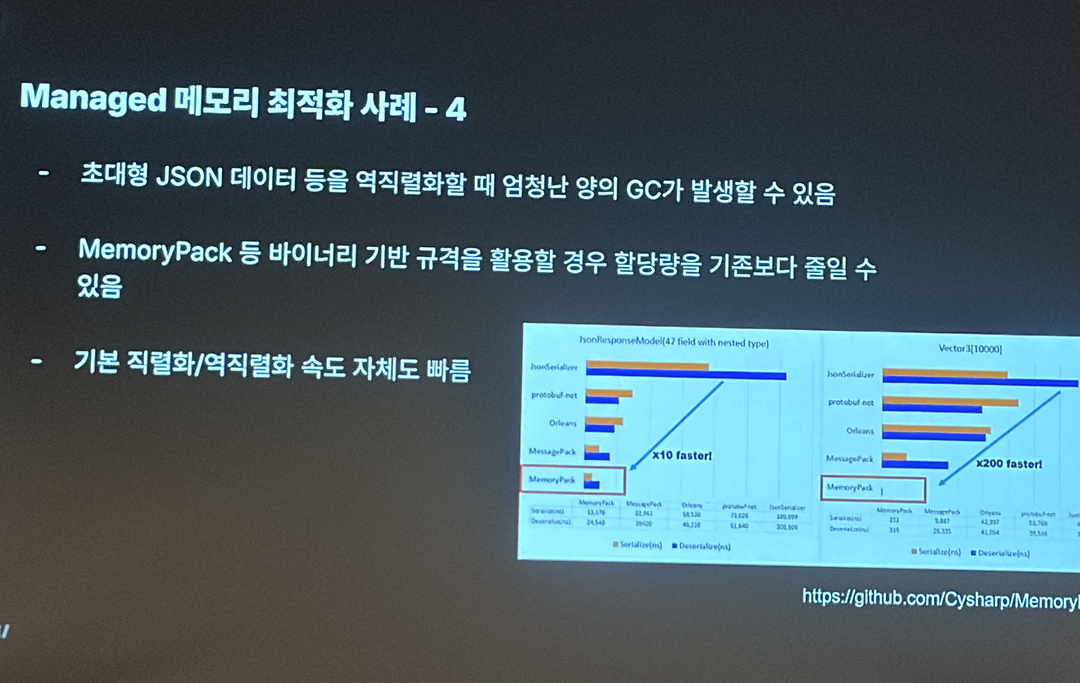
MemoryPack 같은 바이너리 직렬화도 대안이 될 수 있다. 변경된 데이터만 처리하고 중간 문자열 생성을 줄이면 순간 할당량과 저장 크기를 낮출 수 있다.
문자열과 LINQ도 중간 객체를 만든다
문자열은 불변 객체이다.
a + b + c를 단계적으로 수행하면 중간 문자열이 새 객체로 만들어질 수 있다.
반복 조합에서는 StringBuilder나 할당을 억제하는 문자열 처리 라이브러리 ZString을 검토할 수 있다.
LINQ도 연산과 소스 형식에 따라 iterator와 closure를 만들 수 있다. 반복 할당이 문제라면 ZLinq를 할당 감소 대안으로 검토할 수 있다.
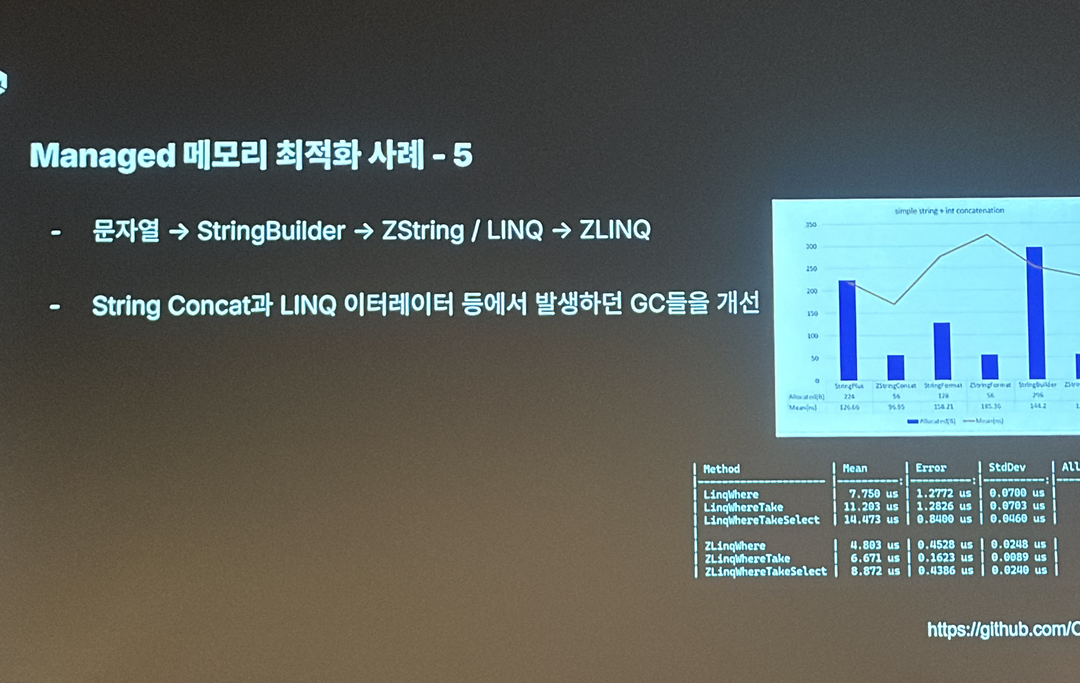
모든 LINQ를 제거할 필요는 없다.
프레임마다 반복되는 hot path인지, 실제로 GC.Alloc이 잡히는지부터 측정해야 한다.
지금까지의 사례는 C# 객체가 있는 Managed Heap의 문제였다. 그러나 Unity 프로젝트에서 더 큰 비중을 차지하는 메모리는 Native 영역인 경우가 많다.
Native 메모리는 다른 수명 규칙을 가진다
Native 메모리는 Unity 엔진의 C/C++ 핵심이 직접 관리하는 영역이다. Managed GC는 이 영역의 객체를 자동으로 수거하지 않는다.
GameObject, Texture, Mesh, AudioClip과 AnimationClip은 C# 객체로 보인다.
그러나 실제 핵심 데이터는 Native 영역의 C++ 객체에 저장된다.
C# 객체는 이 Native 객체를 가리키는 wrapper에 가깝다.
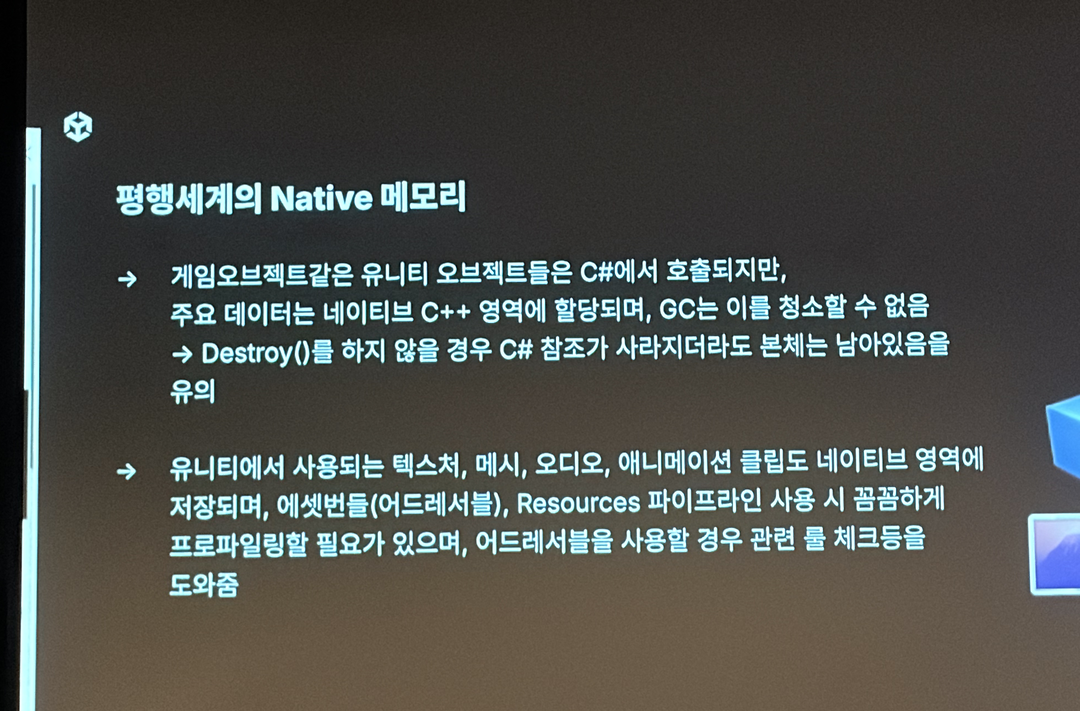
따라서 두 종류의 해제는 서로 다르다.
- C# wrapper는 Managed 참조가 모두 끊긴 뒤 GC가 수거한다.
- Native 객체는
Object.Destroy나 에셋 언로드 경로로 해제한다.
C# 변수에 null을 대입했다고 Native Texture가 즉시 해제되는 것은 아니다.
반대로 Destroy를 호출해 Native 객체를 제거해도 C# wrapper는 GC 전까지 남을 수 있다.
NativeArray<T>는 Managed Heap 밖의 연속된 Native 메모리에 데이터를 저장하는 Unity 컨테이너이다.
Allocator는 Temp, TempJob, Persistent처럼 이 메모리의 예상 수명과 할당 정책을 지정하는 열거형이다.
이 메모리는 Managed GC가 해제하지 않으므로 개발자가 수명과 Dispose() 시점을 직접 관리해야 한다.
무조건 Allocator.Persistent를 선택하면 해제 시점을 놓치기 쉽다.
Resources.UnloadUnusedAssets는 에셋의 도달 가능성을 조사한다
Resources.UnloadUnusedAssets()는 현재 사용하지 않는 Native 에셋을 비동기로 탐색해 언로드하는 Unity API이다.
완료 여부를 확인하거나 대기할 수 있는 AsyncOperation을 반환한다.
GameObject 계층과 static 필드에서 도달하지 못하는 에셋을 찾는다.
이 작업은 Managed GC와 비슷하게 참조 그래프를 조사하지만 대상은 Native 에셋이다.
큰 프로젝트에서는 이 호출과 GC.Collect가 수 초 걸릴 수도 있다.
로딩 화면이나 씬 전환처럼 정지 비용을 통제할 수 있는 지점에 배치해야 한다.
LoadSceneMode.Single에서는 Unity가 이 작업을 자동으로 호출한다.
Native 메모리는 설정과 에셋 구조로 줄인다
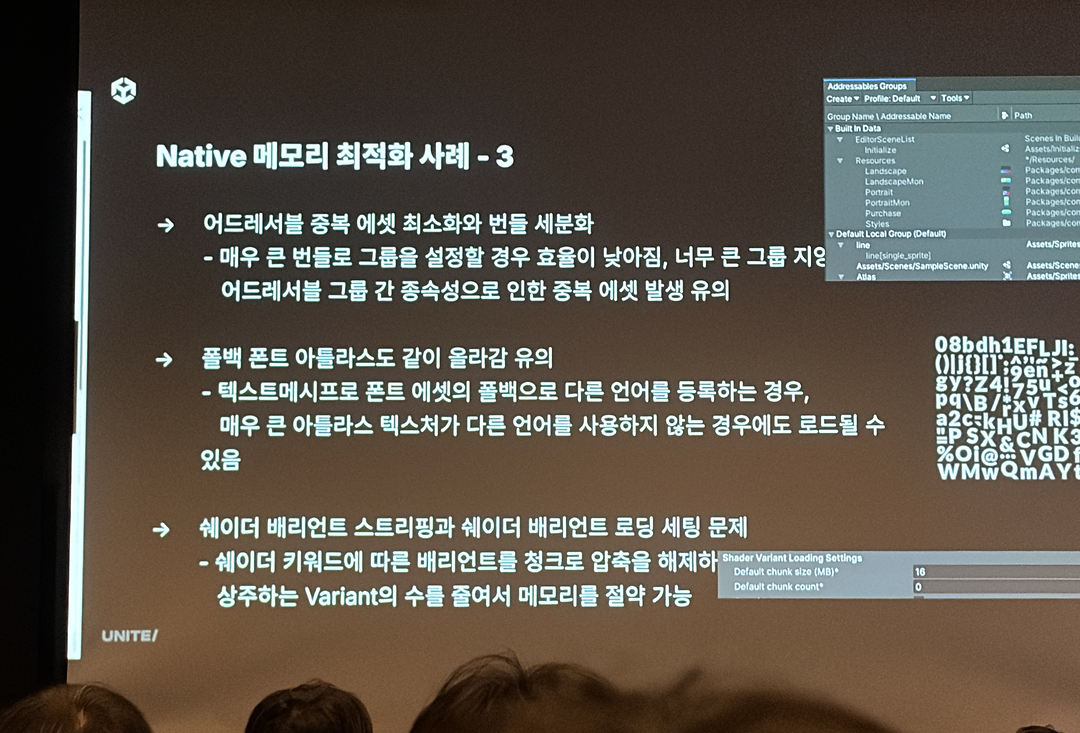
Texture Streaming
Texture Streaming은 카메라와 화면 크기에 필요한 mipmap만 메모리에 올린다. 고해상도 mipmap 전체가 항상 Resident 상태로 남는 일을 줄일 수 있다. 메모리 버짓을 설정하면 런타임이 제한 안에서 mipmap 수준을 조절한다.
반복 오브젝트의 Instancing
위치, 회전과 크기만 다른 같은 Mesh를 수천 개의 GameObject로 만들면 비용이 커진다.
Graphics.RenderMeshInstanced 같은 방식을 사용하면 개별 GameObject와 Transform 수를 줄일 수 있다.
Mesh Read/Write
런타임에서 Mesh를 읽거나 수정하려면 CPU 측 복사본이 필요하다. Read/Write가 켜져 있으면 CPU와 GPU 양쪽에 데이터가 존재해 메모리 사용량이 늘 수 있다. 런타임 수정이 없다면 옵션을 끄는 편이 낫다.
RenderTexture
RenderTexture에 depth나 stencil이 필요하지 않은데도 기본값을 사용하면 불필요한 버퍼가 생긴다. 실제 용도에 맞춰 포맷과 해상도를 낮추면 메모리를 직접 줄일 수 있다.
AssetBundle
AssetBundle을 너무 잘게 나누면 공통 에셋이 여러 번 포함될 수 있다. 반대로 지나치게 크게 묶으면 사용하지 않는 에셋까지 함께 올라올 수 있다. 번들 크기보다 의존성과 동시 로드 범위를 기준으로 구성해야 한다.
Fallback Font
중국어처럼 glyph 수가 많은 폰트를 fallback에 넣으면 큰 atlas가 메모리에 올라올 수 있다. 지원 언어와 실제 사용 범위에 맞춰 폰트 에셋을 나누고 동적 atlas 정책을 검토해야 한다.
Shader Variant
키워드 조합이 많으면 Shader Variant와 관련 Native 메모리도 증가한다. 사용하지 않는 Variant를 제거하고 플랫폼별 빌드에서 실제 포함량을 점검해야 한다.
기존 Unity 런타임의 메모리 구조를 살펴봤으니, 이제 CoreCLR에서 GC 자체가 어떻게 달라지는지 이어서 본다.
CoreCLR에서 GC 구조가 달라진다
2026년 7월 24일 기준 Unity 공식 CoreCLR 전환 계획은 Unity 6.7 LTS에서 CoreCLR Desktop Player를 실험 기능으로 제공한다. Mono를 제거한 CoreCLR Editor와 정식 지원 CoreCLR Desktop Player는 Unity 6.8에 포함할 계획이다. 따라서 CoreCLR의 정식 지원 목표 버전은 Unity 6.8이지만, 정확한 출시일은 아직 공개되지 않았다.
CoreCLR은 root에서 참조를 따라 생존 객체를 찾는 정확한 세대별 추적 GC(precise generational tracing GC)를 사용한다. 여기서 Precise와 Moving은 별도의 GC 이름이 아니라, CoreCLR GC가 참조를 판별하고 생존 객체를 처리하는 방식을 나타내는 특성이다. Boehm GC와 비교했을 때 눈에 띄는 차이는 런타임이 참조 위치를 정확히 알고, SOH에서 객체를 이동하고 압축할 수 있다는 점이다.
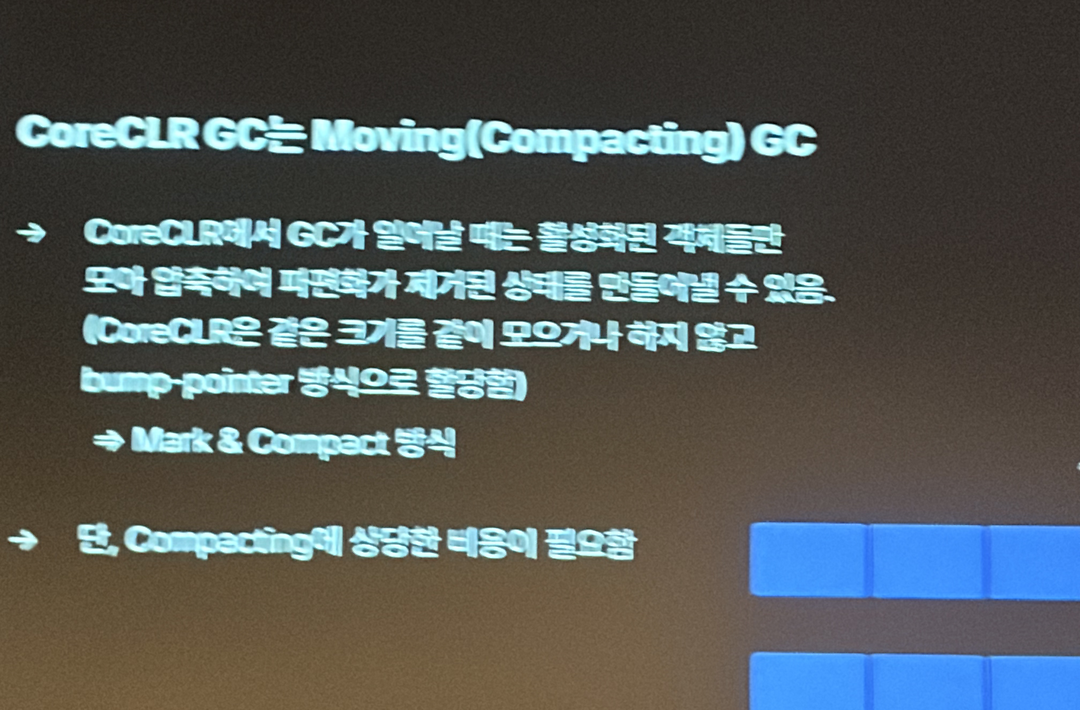
동작을 이해하려면 먼저 새 용어를 정의해야 한다.
- 세대(Generation)는 객체를 살아남은 기간에 따라 나눈 관리 구역이다.
- 세대 가설은 새 객체는 빨리 죽고 오래 산 객체는 계속 살 가능성이 높다는 가정이다.
- 추적(Tracing)은 root에서 객체의 참조를 따라가며 도달할 수 있는 생존 객체를 찾는 과정이다.
- 정확한 참조 추적(Precise reference tracking)은 런타임이 스택, 레지스터와 객체 필드에서 실제 Managed 참조의 위치를 정확히 식별하는 방식이다.
- Collection(수집)은 GC가 특정 세대의 생존 객체를 찾고, 죽은 객체의 공간을 회수하는 한 번의 작업을 뜻한다.
- 승격(Promotion)은 수집에서 살아남은 객체를 더 오래된 세대로 옮기는 정책이다.
- 객체 이동(Moving)은 생존 객체를 힙의 다른 주소로 재배치하고, 해당 객체를 가리키는 참조를 새 주소로 갱신하는 처리이다.
- 압축(Compaction)은 살아 있는 객체를 모아 빈 공간을 한 덩어리로 만드는 작업이다.
- SOH(Small Object Heap)는 85,000바이트 미만의 일반 객체를 Gen 0·1·2로 나누어 관리하는 힙이다. 대부분의 객체 할당이 이 영역에서 일어난다.
- LOH(Large Object Heap)는 85,000바이트 이상의 큰 객체를 별도로 관리하는 힙이다. 큰 객체를 옮기는 복사 비용이 크기 때문에 SOH와 분리하며, Gen 2 수집에서 함께 회수하고 보통은 압축하지 않는다.
이 용어를 바탕으로 Gen 0, Gen 1, Gen 2를 차례로 살펴보자. 먼저 새로 할당된 객체는 대부분 빨리 죽고, 여러 번 살아남은 객체는 계속 살 가능성이 크다는 세대 가설을 기억해야 한다. 이 가설 때문에 전체 힙을 매번 조사하지 않고 새 객체가 있는 Gen 0부터 자주 수집할 수 있다.
SOH와 LOH를 나누는 목적은 객체를 복사하고 압축하는 비용을 통제하는 데 있다. 작은 객체는 이동 비용이 적어 SOH에서 빠르게 할당하고 세대별로 자주 수집할 수 있다. 큰 객체는 매번 옮기면 복사 비용이 커지므로 LOH에 분리해 다른 압축 정책을 적용한다.
Gen 0은 새 객체를 빠르게 할당하고 자주 수집한다
Gen 0은 방금 만들어진 객체가 처음 들어가는 세대이다. 코드가 LOH 임계치보다 작은 객체를 요청하면 CoreCLR은 보통 그 객체를 SOH의 Gen 0에 배치한다. SOH는 새 객체를 위한 연속 공간과 다음 빈 주소를 가리키는 할당 포인터를 유지한다. 할당할 때는 포인터가 가리키는 위치에 객체를 놓고, 포인터를 객체 크기만큼 앞으로 옮긴다. 따라서 Boehm GC처럼 크기가 맞는 free list를 탐색하지 않고도 작은 객체를 빠르게 할당할 수 있다. 이렇게 모은 새 객체를 Gen 0으로 묶으면, 전체 힙 대신 생존율이 낮은 작은 범위만 자주 수집할 수 있다.
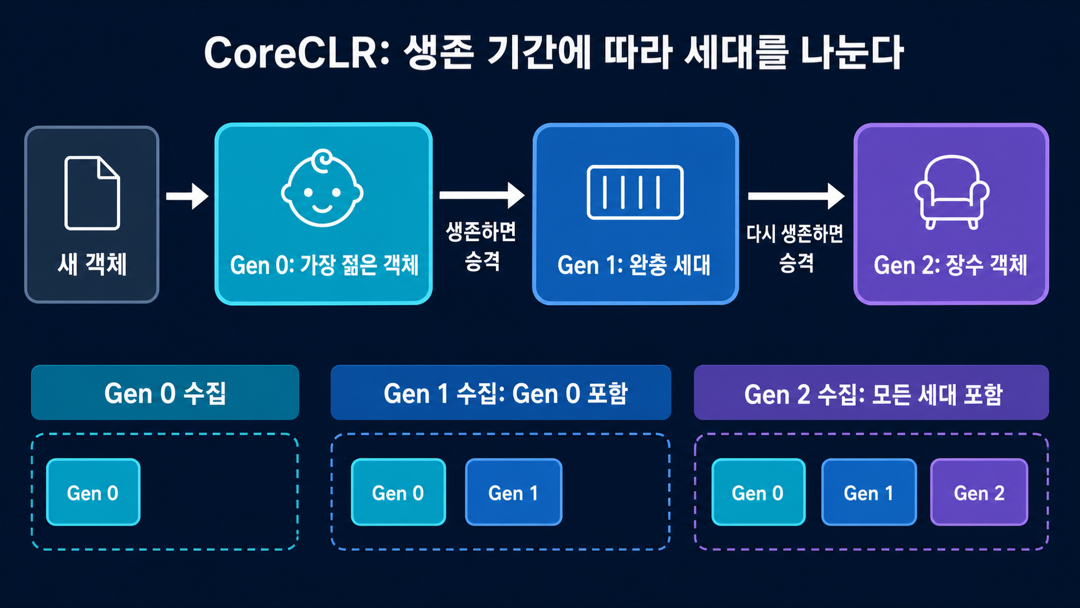
Gen 0에는 런타임이 정한 할당 예산이 있다. 할당량이 이 예산을 넘으면 Gen 0 수집을 검토한다. 예산은 고정된 MB 값이 아니며 실행 중 생존량과 메모리 상황에 따라 계속 조정된다.
Gen 0 수집에서는 root에서 도달 가능한 Gen 0 객체를 생존 객체로 판정하고, 나머지 공간을 다시 쓸 수 있게 회수한다. 살아남은 객체는 일반적으로 모아 배치하고 Gen 1로 승격한다. 세대 가설이 맞으면 전체 힙보다 좁은 Gen 0만 조사해도 많은 공간을 회수할 수 있다.
Gen 1은 단명 객체와 장수 객체 사이의 완충 지대이다
Gen 1은 한 번의 수집에서 살아남았지만 아직 장수 객체로 확정하기 이른 객체를 관리한다. Gen 0과 Gen 2 사이의 완충 역할을 한다.
Gen 1 수집은 Gen 1만 보지 않는다. 수집 대상으로 선택한 세대와 그보다 최근에 할당된 하위 세대를 함께 수집하므로 Gen 0도 포함한다. Gen 1에서 다시 살아남은 객체는 일반적으로 Gen 2로 승격한다.
Gen 2는 오래 살아남은 객체를 관리한다
Gen 2는 여러 수집에서 살아남은 장수 객체를 관리하는 가장 오래된 세대이다. static 데이터와 애플리케이션 전체 수명 동안 유지되는 객체가 대표적이다.
Gen 2 수집은 Gen 0, Gen 1과 Gen 2 전체를 대상으로 한다. 그래서 full GC라고도 부른다. Gen 2에서 살아남은 객체는 더 높은 세대로 가지 않고 Gen 2에 남는다.
세대별 수집의 포함 관계는 다음처럼 정리할 수 있다.
Gen 0 수집: Gen 0
Gen 1 수집: Gen 0 + Gen 1
Gen 2 수집: Gen 0 + Gen 1 + Gen 2
모든 생존 객체가 매번 똑같은 비용으로 처리되는 것은 아니다. 런타임은 세대별 생존율과 회수 효율을 보고 다음 할당 예산과 수집 시점을 조정한다.
Gen 1·2에서 Gen 0으로 향하는 참조도 찾아야 한다
Gen 0만 조사한다고 가정해 보자. Gen 2 객체의 필드가 Gen 0 객체를 가리키면 Gen 0 내부만 보아서는 그 참조를 찾을 수 없다. 그렇다고 Gen 0 수집마다 Gen 2 전체를 다시 훑으면 좁은 범위만 수집하는 장점이 사라진다.
CoreCLR은 write barrier와 card table로 이 문제를 해결한다.
- 이 문맥의 write barrier는 Managed 참조 필드의 변경을 감지하는 런타임 장치이다.
- card table은 힙을 작은 구역으로 나누고 확인할 구역을 표시하는 표이다.
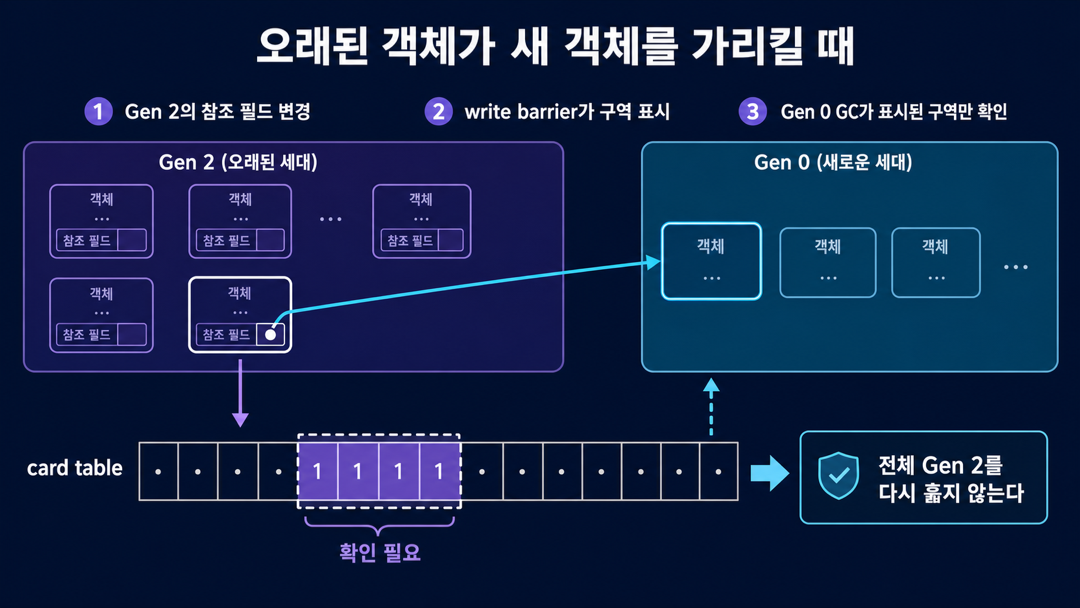
Gen 1이나 Gen 2 객체가 Gen 0 객체를 가리키도록 필드가 바뀌면 write barrier가 실행된다. write barrier는 그 필드가 있는 Gen 1 또는 Gen 2 메모리 구역의 card를 dirty 상태로 표시한다.
다음 Gen 0 수집에서는 dirty card가 가리키는 구역만 추가로 조사한다. 이렇게 하면 Gen 1·2에서 Gen 0으로 들어오는 참조를 놓치지 않으면서 조사 범위를 줄일 수 있다.
정확한 참조 정보가 객체 이동과 압축을 가능하게 한다
CoreCLR은 stack, register와 런타임 구조에서 실제 Managed 참조가 놓인 위치를 알고 있다. Managed 참조는 객체를 가리키는 값이지만, C/C++에서 임의로 연산하는 raw pointer와는 다르다. 런타임이 위치와 자료형을 추적하므로 참조가 아닌 값을 포인터로 오인할 가능성을 줄일 수 있다.
이 정보가 있으면 살아 있는 객체의 바이트를 빈틈 없이 모인 새 힙 주소로 복사한 뒤, 기존 자리를 회수할 수 있다. 이후 root와 다른 객체의 Managed 참조를 모두 새 주소로 갱신하면 이동한 객체를 계속 정확히 가리킨다.
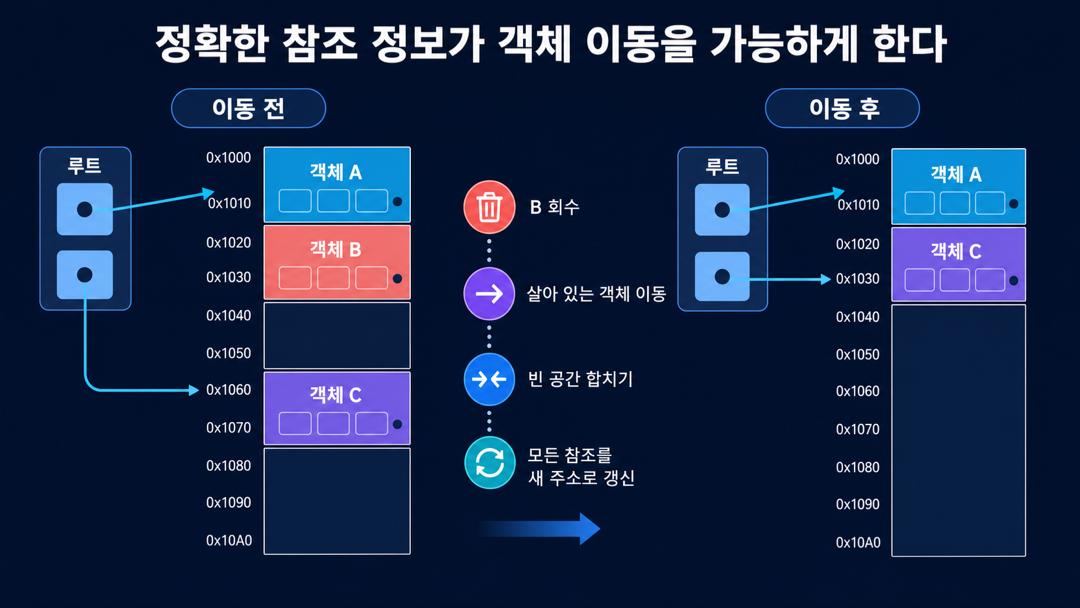
그 결과 흩어진 빈 공간을 한 덩어리로 합치는 Compaction이 가능해진다. 다음 객체는 이어진 빈 공간에 할당할 수 있고, 큰 객체를 위한 연속 공간도 확보하기 쉬워진다.
다만 모든 수집이 항상 객체를 이동하고 압축하는 것은 아니다. 회수할 공간이 적으면 이동 비용이 이득보다 클 수 있다. 고정(pinning)된 객체, 즉 Native 코드가 현재 주소를 안정적으로 쓸 수 있도록 GC가 이동하지 못하게 한 객체는 압축에 제약을 준다.
큰 객체는 LOH에서 다른 정책으로 관리한다
LOH(Large Object Heap)는 복사 비용이 큰 객체를 일반 객체와 분리해 관리하는 영역이다. .NET 공식 문서의 기준은 85,000바이트 이상이다. 대형 배열이나 큰 버퍼가 대표적으로 이 임계치를 넘을 수 있다.
LOH 객체는 처음부터 Gen 0과 Gen 1의 승격 과정을 거치지 않는다. LOH는 물리적 세대를 나타내는 용어로 Gen 3이라고도 부르지만, 논리적으로는 Gen 2 수집 때 함께 수집된다.
큰 객체를 옮기려면 그 크기만큼 메모리를 복사해야 하므로 압축 비용도 커진다.
그래서 LOH는 죽은 객체의 공간은 회수하되, 생존 객체는 보통 매 수집마다 이동하지 않는다.
필요하면 GCSettings.LargeObjectHeapCompactionMode로 압축을 요청할 수도 있다.
대형 배열을 짧은 주기로 만들고 버리면 LOH 임계치를 빠르게 소모한다. LOH 때문에 Gen 2 수집이 잦아지면 장수 객체까지 조사하는 비용이 따라온다. 가능하다면 큰 버퍼를 재사용하는 편이 유리하다.
CoreCLR은 어떤 조건에서 GC를 실행하는가
GC를 일으키는 조건은 하나의 고정 수식으로 정해지지 않는다. 공개 문서에서 확인할 수 있는 대표 조건은 다음과 같다.
- 객체 할당량이 동적으로 조정되는 세대별 임계치를 넘었을 때
- 운영체제가 물리 메모리 부족 신호를 보냈을 때
- LOH 할당량이나 메모리 압력이 높아졌을 때
- 코드가
GC.Collect를 명시적으로 호출했을 때
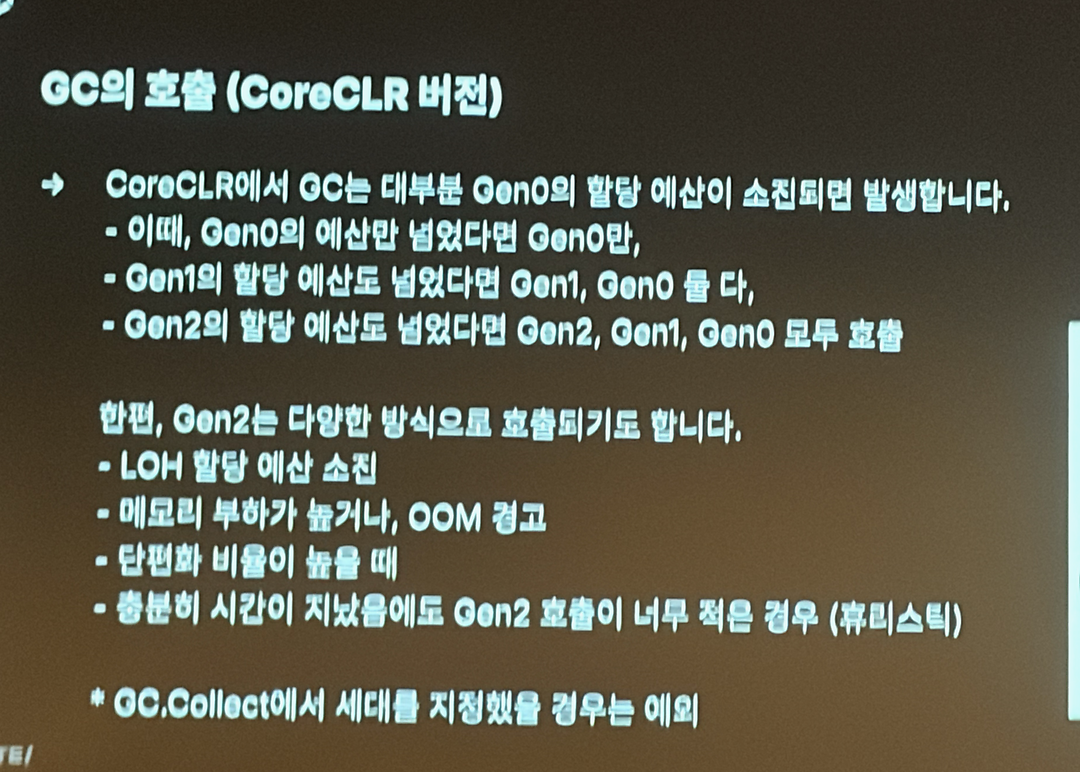
GC.Collect(int)의 인수는 수집할 가장 오래된 세대를 뜻한다.
GC.Collect(0): Gen 0
GC.Collect(1): Gen 0 + Gen 1
GC.Collect(2): Gen 0 + Gen 1 + Gen 2
명시적 호출이 가능하다고 자주 호출해야 한다는 뜻은 아니다. 런타임은 할당 속도, 생존율과 메모리 압력을 바탕으로 수집 시점을 계속 조정한다. 일반적인 코드에서는 자동 정책을 우선하고 특수한 전환 구간에서만 측정 후 사용해야 한다.
강연을 듣고
언리얼 엔진의 Mark-Sweep 방식을 어느 정도 알고 있어서 Unity의 Boehm GC도 낯설지는 않았다. 보수적인 참조 판정과 객체를 옮기지 않는 구조가 불필요한 객체 잔류와 파편화 이슈에 대해 이해할 수 있었다.
CoreCLR의 세대별 GC로 Gen 0·1·2가 어떤 기준으로 관리되는지 그리고 정확한 참조 추적이 객체 이동 후의 주소 갱신으로 Boehm GC의 파편화 이슈를 해결하는 내용도 인상적이다.
CoreCLR 지원이 정식 Unity 릴리스에 포함되고, 실제 프로젝트에서 사용할 수 있는 날이 기대된다.